[TensorRT] Timing Cache로 엔진 빌드를 안전하게 가속하기
GPU·CUDA·TensorRT·BuilderConfig가 다른 timing cache를 섞지 않고 반복 엔진 빌드 시간을 줄이는 안전한 재사용 절차입니다.
앞선 Dynamic Shape Profile 글은 입력 분포에 맞춰 min·opt·max를 정하는 법을 다뤘지만, profile이나 정밀도 조합마다 엔진을 다시 만들 때 늘어나는 빌드 시간은 다루지 않았습니다. 이번 글은 같은 계열 모델을 CI와 배포 노드에서 반복 빌드할 때, TensorRT의 tactic 측정 결과만 재사용하고 최종 엔진 검증은 생략하지 않는 운영 절차를 설명합니다.
대상 환경과 실패 증상
Linux 또는 Windows에서 TensorRT 10/11과 trtexec 또는 Python Builder API로 ONNX 엔진을 반복 생성한다고 가정합니다. 같은 모델과 shape인데도 배포마다 layer tactic profiling이 다시 실행되어 빌드가 수십 분 걸리고, CI timeout이나 GPU 점유 충돌이 발생하는 상황입니다.
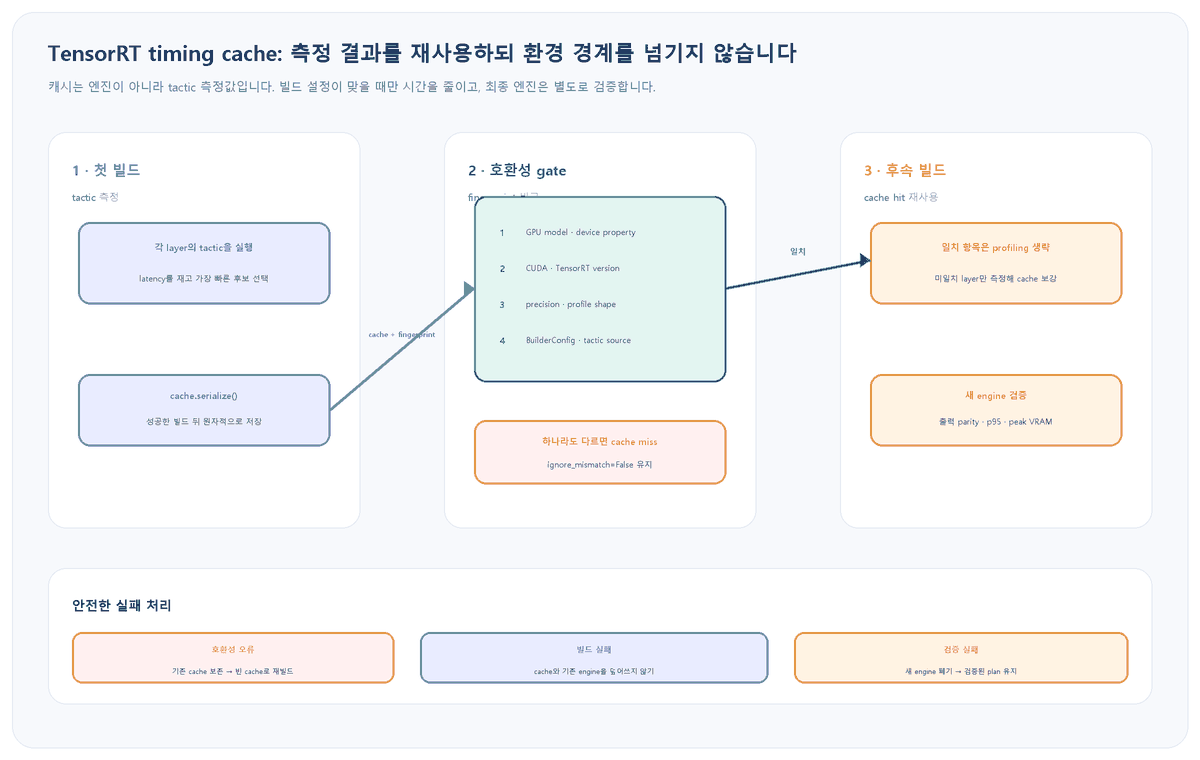
1. cache를 넣기 전에 빌드 기준선을 남깁니다
먼저 cache가 없는 상태에서 모델 hash, TensorRT 버전, GPU, BuilderConfig와 wall-clock 빌드 시간을 한 묶음으로 기록합니다. cache 효과와 설정 변경 효과를 섞지 않기 위한 기준선입니다.
# PowerShell: 환경과 입력 모델을 식별한다
Get-FileHash .\model.onnx -Algorithm SHA256
python -c "import tensorrt as trt; print(trt.__version__)"
nvidia-smi --query-gpu=name,uuid,driver_version --format=csv,noheader

# 같은 shape·precision으로 cache 없는 기준 엔진을 만든다
Measure-Command { trtexec --onnx=model.onnx --saveEngine=baseline.plan --fp16 --minShapes=images:1x3x640x640 --optShapes=images:4x3x640x640 --maxShapes=images:8x3x640x640 --verbose }
기대 관찰값: 로그에 각 layer 후보 tactic의 timing과 선택 과정이 나타나고, 첫 빌드 시간이 기준값이 됩니다. 같은 ONNX라도 opt shape, FP16·TF32·INT8, workspace, tactic source가 달라지면 다른 빌드 계약이므로 fingerprint를 따로 관리합니다.
2. trtexec로 cold build와 warm build를 분리합니다
--timingCacheFile을 지정하면 첫 빌드는 cache miss를 측정해 파일을 채우고, 다음 빌드는 일치하는 항목의 profiling을 재사용합니다. cache 경로는 GPU·TensorRT·정밀도·profile을 구분하도록 이름을 붙입니다.
# 첫 실행: 빈 cache를 만들고 측정 결과를 기록한다
trtexec --onnx=model.onnx --saveEngine=cold.plan --fp16 --minShapes=images:1x3x640x640 --optShapes=images:4x3x640x640 --maxShapes=images:8x3x640x640 --timingCacheFile=cache\trt11.4-rtx4090-fp16-640.bin --verbose

# 두 번째 실행: 같은 계약으로 timing cache를 재사용한다
trtexec --onnx=model.onnx --saveEngine=warm.plan --fp16 --minShapes=images:1x3x640x640 --optShapes=images:4x3x640x640 --maxShapes=images:8x3x640x640 --timingCacheFile=cache\trt11.4-rtx4090-fp16-640.bin --verbose
기대 관찰값: warm build의 tactic profiling 횟수와 wall-clock 시간이 줄어듭니다. 변화가 거의 없으면 cache 경로 권한, cache 크기 증가 여부, layer I/O 구성의 일치 여부를 확인합니다. timing cache가 모든 layer와 plugin을 반드시 포괄하는 것은 아니므로 일부 profiling이 남는 것은 실패가 아닙니다.
3. Python API에서는 strict attach와 원자적 저장을 사용합니다
서비스용 빌더에서는 cache 파일이 없으면 빈 cache를 만들고, 있으면 읽은 뒤 ignore_mismatch=False로 붙입니다. 빌드가 성공한 뒤에만 임시 파일을 최종 cache 경로로 교체해야 중단된 빌드가 정상 cache를 손상시키지 않습니다.
from pathlib import Path
import os
import tensorrt as trt


def build_with_timing_cache(builder, network, config, cache_path):
    cache_path = Path(cache_path)
    cache_bytes = cache_path.read_bytes() if cache_path.exists() else b""
    timing_cache = config.create_timing_cache(cache_bytes)

    if not config.set_timing_cache(timing_cache, ignore_mismatch=False):
        raise RuntimeError("timing cache is incompatible with this build environment")

    plan = builder.build_serialized_network(network, config)
    if plan is None:
        raise RuntimeError("engine build failed; existing cache was preserved")

    updated = bytes(timing_cache.serialize())
    cache_path.parent.mkdir(parents=True, exist_ok=True)
    temporary = cache_path.with_suffix(cache_path.suffix + ".tmp")
    temporary.write_bytes(updated)
    os.replace(temporary, cache_path)
    return bytes(plan)
진단 분기: strict attach가 실패하면 기존 파일을 덮어쓰거나 ignore_mismatch=True로 우회하지 않습니다. 이전 cache를 보존하고 새 fingerprint 경로에서 빈 cache로 빌드합니다. NVIDIA는 다른 device property의 cache를 강제 사용하면 기능 또는 성능 문제가 생길 수 있다고 경고합니다.
4. cache key를 파일명보다 강한 manifest로 고정합니다
파일명은 사람이 읽기 위한 표시일 뿐입니다. 실제 재사용 gate에는 모델 SHA-256과 아래 값을 JSON manifest로 저장하고 완전 일치 여부를 검사합니다.
| 경계 | 기록값 | 달라졌을 때 |
|---|---|---|
| 하드웨어 | GPU model·UUID 또는 device property | 새 cache |
| 소프트웨어 | TensorRT·CUDA·driver·plugin version | 새 cache |
| 네트워크 | ONNX hash·input dtype·profile shapes | 새 namespace 권장 |
| BuilderConfig | precision flags·workspace·tactic sources·optimization level | 동일 계약으로 다시 측정 |
{
  "model_sha256": "9bd4...",
  "tensorrt": "11.4.1",
  "cuda": "13.1",
  "gpu": "NVIDIA GeForce RTX 4090",
  "precision": ["FP16"],
  "profile": {"images": [[1,3,640,640], [4,3,640,640], [8,3,640,640]]},
  "builder_optimization_level": 3
}
운영 기준: 여러 CI job이 같은 cache 파일을 동시에 갱신하지 않게 lock을 두거나 job별 파일을 만든 뒤, 동일한 TensorRT 버전과 device property에서 생성된 cache만 merge합니다. 서로 다른 GPU cache를 강제로 합치는 방식은 사용하지 않습니다.
5. cache miss를 배포 gate로 관찰합니다
warm cache가 충분히 채워졌다고 판단한 뒤에는 지원되는 TensorRT 버전에서 timing cache miss를 오류로 바꾸어, 예상하지 못한 네트워크나 설정 변경을 CI에서 드러낼 수 있습니다. 첫 빌드부터 이 flag를 켜면 정상적인 cache 채우기도 막히므로 warm-up 단계와 검증 단계를 분리합니다.
# cache를 충분히 채운 뒤 검증 job에서만 사용한다
config.set_flag(trt.BuilderFlag.ERROR_ON_TIMING_CACHE_MISS)

# 빌드 실패 시 모델·profile·precision·plugin 변경 여부를 먼저 비교한다
plan = builder.build_serialized_network(network, config)
if plan is None:
    raise RuntimeError("unexpected timing cache miss or engine build failure")
기대 관찰값: 동일 계약의 검증 빌드는 miss 없이 통과합니다. miss가 생기면 cache를 무조건 정답으로 취급하지 말고 변경이 의도된 것인지 확인한 뒤 새 cache를 채웁니다. 이 flag가 설치 버전에 없다면 API 존재 여부를 확인하고 일반 verbose log의 profiling 항목을 비교합니다.
6. 빨리 만들어진 엔진도 출력과 성능을 다시 검증합니다
timing cache hit는 빌드 시간을 줄였다는 뜻이지 새 plan이 서비스 기준을 통과했다는 뜻이 아닙니다. 앞선 엔진 실추론 검증 글의 golden output 검사를 실행하고, baseline과 warm plan을 같은 조건에서 비교합니다.
trtexec --loadEngine=warm.plan --shapes=images:4x3x640x640 --warmUp=1000 --duration=60 --useCudaGraph
python .\verify_engine.py --engine .\warm.plan --golden .\golden.npz --rtol 1e-3 --atol 1e-4
Get-FileHash .\cache\trt11.4-rtx4090-fp16-640.bin -Algorithm SHA256
배포 gate: 출력에 NaN·Inf가 없고 golden output과 허용 오차 안에서 일치해야 합니다. p95 latency와 peak VRAM이 기존 검증된 plan의 허용 범위를 벗어나면 cache 재사용 여부와 관계없이 배포하지 않습니다.
이 초안의 검증 경계
현재 NVIDIA TensorRT 문서에서 timing cache 생성·attach·serialize, strict mismatch, compilation cache, builder optimization level, determinism 계약을 대조했고 Python 예시는 구문 검사 대상으로 구성했습니다. 이 Windows 작성 환경에는 TensorRT와 NVIDIA GPU가 연결되어 있지 않아 실제 cold/warm 빌드 시간, cache hit 수, 출력 parity를 실행하지 않았습니다. 배포 GPU에서 같은 ONNX·profile·precision으로 측정해야 합니다.
롤백과 중단 기준
- cache attach mismatch가 나오면 강제 로드를 중단하고 새 fingerprint 경로에서 빈 cache로 재빌드합니다.
- 빌드가 실패하면 기존 cache와 기존 검증 엔진을 덮어쓰지 않습니다.
- warm plan의 golden output, p95 latency, peak VRAM 중 하나라도 기준을 벗어나면 새 plan을 폐기합니다.
- 문제 분리가 필요하면 timing cache 파일을 제거하거나 새 경로를 지정해 cold build로 복귀합니다. cache 삭제는 기존 plan을 삭제하지 않습니다.
- 빌드 시간을 더 줄이려고 builder optimization level을 낮췄다면 cache 효과와 별개 변경으로 기록하고 추론 성능을 다시 비교합니다.
공식 출처
- NVIDIA TensorRT: Optimizing Builder Performance — Timing Cache
- NVIDIA TensorRT: Optimizing Performance — tactic timing과 determinism
- NVIDIA TensorRT Python API: IBuilderConfig timing cache와 flags
- NVIDIA IBuilderConfig API: setTimingCache와 mismatch 경고
- NVIDIA ITimingCache API: serialize·combine·reset
- NVIDIA TensorRT Capabilities: trtexec와 serialized timing cache